作成者:さっつーのAIエージェント 監修 今泉大輔
作成日時:2026年11月10日午前
エグゼクティブ・サマリー
本レポート(全3部作の第2巻)の核心的テーゼは、たとえNVIDIAのジェンスン・フアン最高経営責任者(CEO)がガバナンス危機により退場を余儀なくされ、同社のAI半導体市場シェア(およびTSMCのCoWoS先端パッケージ占有率)が従来の85%水準から2026〜2027年にかけて45〜60%レンジへと軟着陸したとしても、インダストリアルAIおよびフィジカルAIという「大陸横断鉄道の線路」を流れる計算需要は一切減速せず、むしろ非NVIDIA陣営の3大成長エンジンによって市場全体が新たな爆発フェーズに突入するという点にある1。19世紀後半の米国において、大陸横断鉄道の建設を主導した「鉄道王」たちがスキャンダルや金融恐慌で表舞台から退場した際も、すでに敷設された鉄道網と貨物輸送需要は消滅せず、独占的運賃の崩壊がTCO(総所有コスト)の低下と重工業化の加速をもたらした。これと全く同じ構造転換が、2026年11月現在のグローバルAIデータセンター市場で進行している。
現在、約5兆ドルの時価総額を誇るNVIDIAのコーポレート・ガバナンスは重大な転機を迎えている3。シンガポールを拠点とするクラウド事業者Megaspeedおよびそのマレーシア関連会社Speedmatrixを経由した48億ドル規模のNVIDIA製先端ハードウェア調達ルートと、中国国家安全部(MSS)との関連が米情報機関から疑われているMegaspeed元幹部アリス・フアン(黄楽)氏とジェンスン・フアンCEOの個人的関係に関する報道を受け、米下院の中国特別委員会がブリーフィングを要求し、NVIDIA取締役会も独立調査を開始した3。このガバナンス問題は、単一ベンダー依存(Single Point of Failure)の解消を模索していたハイパースケーラーおよび米国防総省(War Department)にとって、調達構造を多様化させる決定的な契機となった3。
しかし、日本の機関投資家およびファンドマネージャーが最も警戒すべき認知バイアスは、「NVIDIAのシェア低下=AIインフラ投資サイクルのピークアウト」という短絡的な連想である。調査会社TrendForceが公表したデータによれば、世界の主要クラウドサービスプロバイダー(CSP)8社(Google、AWS、Meta、Microsoft、Oracle、Tencent、Alibaba、Baidu)による2026年の設備投資総額(CapEx)は前年比約61%増の7,100億ドル超に達し、米主要ハイパースケーラーだけでも6,600億〜7,300億ドル規模(うち約75%がAI特化型インフラ)という空前の資本投下が継続している7。また、TSMCの2026年第3四半期売上高は前年同期比50.9%増の1兆4,942億4,300万台湾ドルと過去最高を更新し、2026年通期の設備投資計画も従来の520億〜560億ドルから600億〜640億ドルへと引き上げられた10。計算需要(トークン生成量)は、学習(Training)から推論(Inference)・エージェントAIへの構造転換を経て指数関数的な膨張を続けている8。
縮小するNVIDIAのシェア空白を埋め、市場全体のTAM(獲得可能最大市場規模)を数倍へと押し上げている「3つの巨大成長エンジン」の全体像は以下の通りである。
第1の成長エンジンは、Broadcom(AVGO)およびMarvell Technology(MRVL)の2社が共同設計(Co-design)市場の約95%を握る「カスタムASIC(特定用途向け集積回路)」の急拡大である1。GoogleのTPU v7(Ironwood)および次世代v8系、AWSのTrainium2/3/4、MetaのMTIA 300〜500世代、MicrosoftのMaia 200に加え、OpenAIがBroadcomおよびTSMCと組んで9ヶ月でテープアウトさせた推論特化型3nmチップ「Jalapeño(ハラペーニョ:10GW展開計画)」が加わり、TrendForce推計で2026年のカスタムAIチップ出荷成長率は前年比44.6〜45%増と、GPU出荷成長率(同16%増)の約3倍のスピードで拡大している1。
第2の成長エンジンは、リサ・スーCEO率いるAMDによる「ラックスケール統合戦略」と防衛・ソブリンAI需要の吸収である。AMDはZT Systemsの買収を通じて獲得したシステム設計力と、Pensando(Pollara 400 / Vulcano 800)のAIネットワーク技術を結集し、CDNA5世代の「Instinct MI455X(432GB HBM4搭載)」を72基統合したオープン規格ラック「Helios」を2026年7月に量産開始した15。NVIDIAのGB200 / Vera Rubin NVL72に対抗するこのターンキー・ラックスケール基盤は、オープンなUltra Ethernet Consortium(UEC v1.1)およびUALinkと相まって、ペンタゴンや各国政府の機密領域(Air-Gapped環境)およびクラウドのセカンドソース需要を吸収している2。業界推計では、AMDのTSMCにおけるCoWoS確保量は2026年の13万枚から2027年には前年比307%増の53万枚へと急増し、Broadcomを抜いて世界第2位に浮上する見通しである2。
第3の成長エンジンが、イーロン・マスク氏率いるSpaceX・Tesla・xAIがテキサス州で推進する垂直統合半導体ファブ「Terafab(テラファブ)」計画である19。グライムズ郡ギボンズクリーク(Gibbons Creek)の旧石炭火力発電所跡地を中心とする約2,900エーカーの工場サイト(再投資ゾーン全体では22,000エーカー超)、延床面積1億平方フィート超に及ぶこのメガプロジェクトは、フェーズ1の168億ドルから全4フェーズ合計で最大1,190億ドルを投じ、ロジック・メモリ・先端パッケージ・テストを単一拠点で一貫生産する計画である19。2032年までに月産100万枚(300mmウェハ換算)を目指すその内訳は、Intel 14A(1.4nmクラス)プロセス技術等を導入するロジック半導体が月産30万枚超であるのに対し、メモリ半導体が月産約70万枚(現在のSamsung電子のDRAM全生産能力65万〜70万枚に匹敵、日本のRapidusの月産2.5万枚構想の40倍)に達する19。さらにマスク氏は、年間1テラワット(1TW)規模のAI算力構築を目指し、完全再使用型ロケット「Starship」を用いてSpaceXの「軌道上(宇宙)AIデータセンター(AI1 / Starmind衛星、最大100万機申請)」へ大規模配置し、太陽同期軌道での常時太陽光発電と宇宙空間への赤外線放射冷却によって地上の電力・冷却ボトルネックを突破する実行フェーズへと移行している27。
本稿では、これら3つの非NVIDIA成長エンジンの技術アーキテクチャ、サプライチェーンの配分変化、キャッシュフロー創出構造、そして日本の半導体製造装置(SPE)セクターへの波及効果を定量・技術の両面から詳述する。
第1章:NVIDIA一強の終焉とAIデータセンター建設モメンタムの再定義
1.1 東南アジア「グレーゾーンNeoCloud(Megaspeed / Speedmatrix)」の淘汰と正規需要による吸収メカニズム
2026年11月に表面化したNVIDIAのガバナンス問題は、単なる経営者個人のスキャンダルにとどまらず、過去数年間にわたりNVIDIAの売上成長の一翼を担ってきた「東南アジアの新興クラウド事業者(NeoCloud)経由のハードウェア調達網」に対する米国政府の監視強化を浮き彫りにした3。
事の発端は、シンガポールおよびインドネシア、マレーシアでAI計算資源のレンタル事業を展開するクラウド企業「Megaspeed」と、その元マネージング・ディレクターである中国人実業家アリス・フアン(黄楽)氏を巡る米情報機関および議会の調査であった3。シンガポールの法人登記記録によれば、Megaspeedの前身は中国のゲーム開発企業7Roadにルーツを持つ「7Road International」であり、2023年3月にアリス・フアン氏がマネージング・ディレクターに就任したのと同時期に社名をMegaspeedへと変更している4。ニューヨーク・タイムズ紙が引用した貿易記録によれば、Megaspeedのマレーシア関連会社である「Speedmatrix」は、2024年6月から2026年2月までの間に、NVIDIAのH100やGB200を含む先端AIハードウェアを少なくとも48億ドル相当購入していた4。Megaspeedはこれら東南アジアのデータセンターに設置されたNVIDIA製GPUクラスタの計算能力を、米国の対中輸出規制下で先端チップの物理的輸入を制限されているAlibaba等の中国企業にリモート提供していたと報じられている3。
さらに、米情報機関が2026年春にトランプ政権高官の間で回覧した機密メモにおいて、アリス・フアン氏が中国国家安全部(MSS)にリクルートされ、ジェンスン・フアンCEOとの個人的関係(2004年6月および2005年5月の台北での会食・同席写真等が報じられている)を通じて情報収集や対中半導体供給スタンスへの影響工作を行っていた疑いが指摘された3。2026年11月5日には米下院の中国特別委員会がアリス・フアン氏を「報告された中国情報機関のアセット」と公に指摘してジェンスン・フアン氏へのブリーフィングを要求し、フアンCEO自身も過去の個人的関係を認めた上で、NVIDIA取締役会が国家安全保障上の懸念に関する独立調査を開始したことを確認した3。NVIDIA側は国家安全保障や企業秘密が侵害されたと信じる理由はないと声明を出しており、Megaspeed側も米国商務省産業安全保障局(BIS)やマレーシア投資貿易産業省(MITI)、NVIDIAの現地査察で違反は確認されなかったとして違法な物理的移転を否定しているものの、シンガポール警察も独自の捜査を開始している3。この事案により、米国輸出管理政策の焦点は「物理的なチップがどこに届いたか」だけでなく「誰がその計算能力へのリモートアクセスを許されているか」へと広がっている4。
バイサイドのアナリストにとって重要な定量的な問いは、「Speedmatrixの48億ドルに象徴される東南アジアのグレーなNeoCloud需要が規制強化で停滞・淘汰された場合、AIサーバー市場全体に在庫調整や出荷減速が生じるのか」という点である。結論から言えば、この出荷調整ノイズは一時的な摩擦にとどまり、日米欧および中東の正規ハイパースケーラーと「ソブリンAI(Sovereign AI:国家主権AI)」の未消化需要によって吸収される構造にある。
その根拠は、ファウンドリおよびパッケージング工程における供給不足と、正規プレイヤーの巨大な設備投資枠にある。第一に、TSMCの3nmプロセスは2026年上半期時点で稼働率100%に達しており、需要が供給能力の約3倍(Demand running approximately three times higher than available supply)に達しているため、あらゆるアクセラレータ(GPUおよびASIC)のリードタイムが12〜18ヶ月に延びている7。東南アジアのNeoCloud向けに割り当てられていた出荷枠に変動が生じたとしても、同じTSMCの3nmウェハおよびCoWoS枠を必要としている米国CSP(2026年の設備投資見通しはAlphabetが1,783億〜1,900億ドル、Metaが1,245億〜1,450億ドル、OracleのStargateプロジェクト等)がそれを吸収する余地が極めて大きい8。
第二に、2026年に世界で最も潤沢な資金が投じられている地政学的インフラプログラムである「ソブリンAI」が、大規模な正規需要を創出している31。具体的には、サウジアラビアの「HUMAIN」が11拠点・合計約2.2GWのデータセンター容量に対して複数年で約1,000億ドルの支出をコミットし、数十万基規模のアクセラレータ(NVIDIAのB200、GB200、RubinおよびAMD製GPU等)を調達しているほか、アラブ首長国連邦(UAE)のG42が主導する「Stargate UAE」(推定約250億ドル、合計1GW/フェーズ1で200MW)および広範なG42ソブリンAI計画(推定約300億ドル、追加約1.5GW)、インドの「IndiaAI Mission」(約100億ドル、8エクサフロップスのG42展開スーパーコンピュータ構築を含む)、欧州のEuroHPC JUが資金提供する13箇所のAIファクトリー(初期容量計約600 PFlops)、カナダのソブリンAIコンピュート(約24億カナダドル)、さらに米国企業MeetKaiがブラジル・ウクライナ・パキスタン・カザフスタン・ウズベキスタン・バングラデシュの6カ国(合計人口7億人超)で展開するソブリンAI計画など、国家主導のインフラ投資がグローバルに拡大している31。
1.2 クローズドモデルから「推論・オープンウェイト・エージェントAI」への計算負荷シフト
AIデータセンターの建設モメンタムを再定義しているもう一つの構造変化は、ワークロードの重心が「大規模言語モデル(LLM)の事前学習(Training)」から「大規模推論(Inference)、強化学習環境(RL Environment)、およびエージェントAI(Agentic AI)」へとシフトしていることである8。
TrendForceが指摘するように、GPT系モデルの学習は一度完了すれば投資サイクルが一段落する側面があるのに対し、学習済みモデルを実際の検索(Googleの月間25億人超が利用するAI Overviews等)、コーディング(OpenAIのCodex等)、ソーシャルメディアのコンテンツランキング、エンタープライズ業務に組み込む「推論」処理は、サービス利用者が増えるほど計算資源を消費し続けるため、継続的なデータセンター拡張を必要とする8。OpenAIの週次アクティブユーザー数は3億人超から8億人超へと急拡大しており、フランスのMistralや中国のDeepSeek、MetaのLlama系に代表されるモデルやローカルLLMの普及も、エンタープライズや政府機関における推論需要を押し上げている5。
この「学習から推論・エージェントへのシフト」は、データセンターが要求するシリコン(半導体)の物理的・経済的構造に2つの大きな変化をもたらしている。
- 演算密度(FLOPS)からメモリ帯域・容量(HBM Capacity & Bandwidth)へのボトルネック移動: 大規模学習においては、多数のプロセッサ間で勾配を同期するAll-Reduce通信と大規模な行列演算が重視される11。一方、LLMの推論(特にDecodeフェーズ)や長大なコンテキストを扱う処理においては、モデルのパラメータ重み(Weights)とKey-Value(KV)キャッシュ、アクティベーションをメモリ上で高速に扱う必要があるため、レイテンシとメモリ帯域幅(TB/s)・メモリ容量が最重要となる11。十分なHBM容量があればモデル並列化の複雑さやインターコネクト通信のオーバーヘッドを最小化できるほか、エージェントAIの普及に伴い汎用サーバーやホストCPU(AMDのEPYC VeniceやGoogleのAxion、AWSのGraviton5等の3nmプロセスCPU)への投資も同時に拡大している1。
- 汎用GPUのオーバーヘッド排除と「1トークンあたりコスト(Cost per Token)」の追求: 汎用GPUは、グラフィックス描画エンジンやビデオデコードブロック、科学技術計算用の倍精度浮動小数点(FP64)ユニット、汎用キャッシュなど、LLMの推論には直接必要とされない回路ブロックを抱えている14。OpenAIは2025年時点で売上高の約50%を推論コンピュートコストに費やしていたと報じられており、膨大なトラフィックを処理する事業者にとって、1トークンあたりのコストを20%改善するだけでも年間数億ドルのコスト削減となり、50%削減できれば事業構造そのものが一変する14。そのため、不要な回路を省いてシストリック・アレイ(Systolic Array)と大容量HBM、およびMixture-of-Experts(MoE)ルーティング用のオンチップSRAMに特化したカスタムASICや、大容量HBM4を搭載したラックスケールシステムへの移行が経済合理性を持つに至っている14。
1.3 なぜCIOや調達委員会は「NVIDIA 100%依存」を止めざるを得ないのか
企業の最高情報責任者(CIO)、ハイパースケーラーのインフラ調達部門、そして各国の防衛・情報機関が2026年に入り「NVIDIA 100%依存」からの脱却を進めている理由は、以下の3つの要因に集約される。
第一に、ガバナンスおよびセキュリティ・サプライチェーンリスクの回避である。2025年の米国国家安全保障戦略(National Security Strategy)および2026年1月9日付の米国防総省(Department of War)AI戦略メモランダム、同年4月17日付の米空軍省(DAF)AI戦略が明記している通り、防衛・連邦政府機関のインフラには「主権(Sovereignty)、レジリエンス、信頼性」が求められており、ベンダーロックインによるサプライチェーンリスクや外部依存は回避すべき課題と定義されている6。このような環境下において、NVIDIAのCEOを巡る国家安全保障上の懸念から議会要求や社内取締役会の独立調査が発生した事実は、機密環境(IL4/IL5やSCIF等)を扱う調達部門にとって、特定ベンダーへの単独依存を避けマルチベンダー化・ソブリンAI化を進める強い動機となっている3。
第二に、TCO(総所有コスト)とレンタル価格の上昇である。Morgan Stanleyが引用したCompute Deskのデータによれば、NVIDIAのBlackwell世代GPUのレンタル価格は2026年初来で約30%上昇し、1GPU時間あたり約5.25ドル(1ワットあたり約20〜25ドル換算)に達しているほか、ハイパースケーラーとNeoCloudの間でGPU時間単価に2〜3倍の価格差が生じている35。これに対し、Google Cloudが公開している自社ASIC「TPU v6e(Trillium)」のオンデマンド価格は1チップ時間あたり2.70ドル(Google社内ベンチマークではLLMワークロードにおいてNVIDIA H100インスタンス比で約4倍の価格性能比)、第7世代「TPU v7(Ironwood)」でもオンデマンドで12.00ドル、1年コミットメントで8.40ドル、3年コミットメントでは5.40ドルに設定されている1。
第三に、データセンターの熱設計電力(TDP)と冷却設備改修(Retrofit CapEx)の負担である。NVIDIAの次世代フラッグシップGPU(Vera Rubin等の1,000W〜1,400W級構成)が高密度な液冷や液浸冷却を要求し、既存施設の液冷改修コスト(Retrofit costs)がグリーンフィールド新設コストの1.5〜2.5倍に達するのに対し、GoogleのTPU v7(推定約500W)やAWSのTrainium3(約600W)、OpenAIのJalapeño(700W)などのカスタムASICは500〜750Wの電力枠内で稼働し、ダイレクト・トゥ・チップ液冷やリアドア熱交換器で対応可能である7。このファシリティ面での投資効率の差も、非NVIDIA陣営へのシフトを後押ししている。
第2章:非NVIDIA陣営の急拡大①――カスタムASIC(Broadcom / Marvell)による覇権奪取
2.1 主要ハイパースケーラーおよびOpenAIの独自ASICロードマップ(2026〜2028年)と性能対コスト比
2026年は、ハイパースケーラーおよびフロンティアAIラボによるカスタムASICが本格的な量産フェーズに入った転換点(Custom Silicon Inflection Point)である7。Bloomberg Intelligenceの試算によれば、カスタムASIC市場は2033年にかけて年平均成長率(CAGR)44.6%で拡大し、Counterpoint Researchも上位10社のAIサーバーCompute ASIC出荷台数が2024年から2027年の間に3倍増になると予測している7。かつてGoogle(2024年シェア64%)とAWS(同36%)の2社複占だったASIC市場は、Meta、Microsoft、そしてOpenAIとAnthropicの参入により大きく裾野を広げている13。各社の2026〜2028年ロードマップと技術・経済仕様は以下の通りである。
| 開発主体 / チップ名称 | 設計・製造パートナー / プロセス | 主要演算性能・メモリ仕様(HBM容量 / 帯域幅) | 消費電力(TDP) / スケールアップ構成 | 展開時期・コスト優位性(Perf/Watt/Dollar) |
| Google TPU v6e (Trillium) / TPU v7 (Ironwood) / TPU v8i (SunFish)・v8t (ZebraFish) | Broadcom(v7, v8i) MediaTek(v8t) TSMC 3nm / CoWoS2 | v7 Ironwood: 4,614 TFLOPS (FP8)、192 GiB HBM、帯域約 7.4 TB/s35 v8i: 384 MB オンチップSRAM搭載(MoEルーティング用)35 | v7: 推定約500W7 光回線スイッチ(OCS)とICIによる3Dトーラス網で1ポッド最大9,216チップ(共有HBM 1.77 PB)、v8tは単一ファブリック最大13.4万チップ35 | v6e: |
| AWS Trainium2 / Trainium3 / Trainium4 | Annapurna Labs / Marvell連携 TSMC 3nm(Trainium3〜)1 | Trainium3: 2.517 PFLOPS (FP8)、144 GB HBM3e、帯域 4.9 TB/s(Trn2比で演算約2倍・メモリ1.5倍)1 Trainium4: Trn3比でFP8 3倍・FP4 6倍・帯域4倍、推定288 GBメモリ1 | Trainium3: 約600W7 Trn3 UltraServer: NeuronSwitchで144チップ統合(362 PFLOPS FP8、20.7 TBメモリ、Trn2比4.4倍性能)1 Trainium4: NVLink Fusion対応1 | 累計100万基以上のTrainiumを展開済1。インディアナ州Project Rainier(投資額110億ドル、2.2GW)でAnthropic向けにTrainium2を約50万基稼働1。OpenAIとも2GWのTrainium容量契約を締結1。Trainium4は2026年末〜2027年初頭投入予定1。 |
| Meta MTIA 300 / 400 / 450 / 500 (旧世代: MTIA 100/200) | Broadcom(複数年契約、2nm世代含む) TSMC 3nm / CoWoS1 | MTIA 400: 6 PFLOPS (FP8) / 18 PFLOPS (MX4)、288 GB HBM(帯域 9.2 Tbps)1 MTIA 500: 10 PFLOPS (FP8) / 30 PFLOPS (MX4)、最大512 GB HBM(帯域 27.6 Tbps)、2×2チップレット構成1 | MTIA 400: 1,200W1 MTIA 500: 1,700W1 Broadcomの先端Ethernet技術で大規模クラスタ接続11 | 2026年3月に4世代(300/400/450/500)を発表、約6ヶ月周期で新設計を投入し300から500で演算性能25倍・HBM帯域4.5倍に拡張1。MTIA v4(Santa Barbara)ではHBM4も採用7。MTIA 500は2027年量産展開予定1。 |
| Microsoft Maia 200 | Marvell連携 TSMC 3nm7 | 推論特化型第2世代アクセラレータ(Azure上のAIサービス推論効率改善に特化)8 | TSMC 3nmプロセス採用7 | 2026年1月26日発表、米中西部(US Central)Azureリージョンに初期配備、次いでUS West 3へ展開11。2027年にかけて量産ランプアップ40。 |
| OpenAI Jalapeño(ハラペーニョ) | Broadcom(シリコン共同設計) Celestica(ラック・熱設計ODM) TSMC 3nm14 | レチクルサイズのシストリック・アレイ推論ASIC。8スタックのHBMを2.5Dインターポーザ上に配置(Blackwell世代と同等クラスの性能)14 | 700W(1,400W級のNVIDIAフラッグシップGPUを上回る推論効率)14 | AI支援設計により9ヶ月でテープアウト、2026年6月発表時点でラボ稼働中14。1トークンあたり推論ドルコストをNVIDIA比で約50%削減目標14。2026年後半から2029年にかけ計10GWを展開予定(初回生産分の約40%はMicrosoftがAzure向けに購入予定)14。 |
カスタムASIC勢はこれまで課題とされてきた「ソフトウェアの移行障壁」の低減にも注力している。従来、GoogleのTPUはXLAコンパイラ(JAX等)への依存度が高く、AWSのTrainiumもAWS Neuron SDK(NKIカーネル)への書き換えが必要であり、既存GPUエコシステムとの互換性やハードウェアとソフトウェアの調整が課題として指摘されてきた8。しかしGoogleは2026年10月20日、AI開発フレームワークであるPyTorchをTPUおよびAWS Trainium(Trainium2/3)上で動作させる実行基盤「TorchTPU」をオープンソース(パブリックベータ)として公開し、ポータビリティの改善を進めている35。
とりわけ注目されるのが、OpenAIがBroadcomおよびCelesticaと共同開発した初の独自推論ASIC「Jalapeño(ハラペーニョ)」である14。OpenAI自身のAIモデルを半導体設計に活用することで、初期設計から製造テープアウトまでを「9ヶ月」で完了させたこのチップは、300mmウェハのレチクルサイズ限界のダイ面積をシストリック・アレイ演算器と8個のHBMスタックとの通信帯域に集中させている14。その結果、700Wの設計でありながら1,400WのNVIDIA製フラッグシップGPUを上回る効率を示し、1トークンあたりの推論ドルコストを約50%削減することを目指している14。OpenAIとBroadcomは2026年後半のプロトタイプ導入から2027年の本格量産、2028年上半期のピーク展開を経て、2029年末までに合計10ギガワット(10GW)のカスタムアクセラレータ容量を展開する計画を発表しており、初回生産分の約40%はMicrosoftがAzure向けに引き取る見通しと報じられている14。また、OpenAIは次世代プロセッサの製造先としてSamsung電子の活用も示唆しているほか、AnthropicもNVIDIA製GPUをバイパスするための独自推論チップの共同設計を進めており、みずほ証券のアナリストはBroadcomとAnthropicの提携だけでも2026年に210億ドル、2027年には420億ドルの売上を生む可能性があると試算している13。
2.2 TSMCの3nm/2nmおよびCoWoSキャパシティにおける「NVIDIA対非NVIDIA勢」のシェア推移
AI半導体の勢力図を測る上で重要な先行指標となるのが、TSMCの先端ノード(3nm/2nm)および先端パッケージング「CoWoS(Chip-on-Wafer-on-Substrate)」のウェハ確保量(アロケーション)である。GPUやASICのダイを大量に製造できても、CoWoSでHBMと統合できなければ完成品として出荷できないため、CoWoS能力が各社の売上上限を規定する10。
台湾の経済日報(EDN)やTrendForce等の報道によれば、TSMCは3nm(N3E/N3P/N3X)の生産能力を2026年末の月産18万枚超から2027年半ばに月産21万枚へ、2025年第4四半期に量産入りした2nm(N2および2026年後半量産のN2P)の能力を2026年末の月産約6万〜9万枚から2027年半ばに月産約11万枚へと拡張し、CoWoSの生産能力も2026年末の月産約13万枚から2028年末には月産約26万枚へ倍増させる計画とされる(なお、これらの能力数値はTSMCが公式に確認したものではない)1。このCoWoSキャパシティを巡る主要プレイヤーの2026年および2027年の需要・割当予測と、Broadcomの四半期AI半導体売上の推移を示したのが以下の複合チャートである。
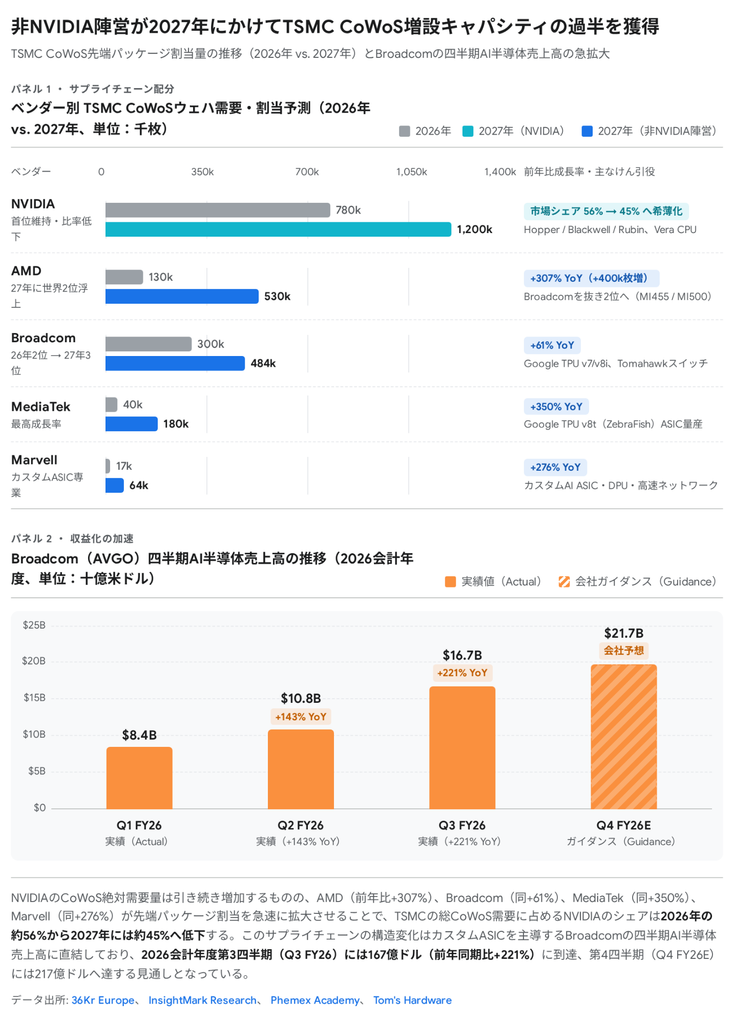
サプライチェーンの分析(36Kr等が報じた業界推計)によると、2026年時点ではNVIDIAがTSMCのCoWoSキャパシティにおいて78万枚(別推計では約59.5万枚、シェア約56〜60%)を確保し首位を維持している1。その内訳は、Hopper・Blackwell・Rubin世代のGPU向けが「CoWoS-L」、予想出荷数575万個のVera CPU向けが「CoWoS-R」(需要10万枚超)、QuantumおよびSpectrumネットワークスイッチチップ向けが「CoWoS-S」である2。しかし2027年には、NVIDIAのCoWoS需要が120万枚(増分42万〜44.2万枚)へと伸びる一方で、他社の急拡大により、NVIDIAのCoWoS総需要に占めるシェアは2026年の約56%から2027年には約45%へと希薄化すると予測されている2。
このシェア希薄化の裏側で急伸しているのが、以下の非NVIDIA陣営である。
- AMDの躍進(2026年13万枚 → 2027年53万枚、前年比+307%): AMDは1年間でCoWoS需要を40万枚積み増し、NVIDIAの増分(44.2万枚)に迫る規模拡大を見せ、2027年にはBroadcomを抜いてCoWoS需要の世界第2位に浮上する見通しである2。この牽引役は2027年の主力製品となる「Instinct MI455X」の立ち上がりと、2027年末に少量生産が始まる次世代「MI500(開発コードネーム:Arcadia)」、および3D V-Cacheとチップレット構造の採用拡大である2。また、エージェントAI需要に伴い675万ユニットの出荷が見込まれるAMDの次世代サーバーCPU「EPYC Venice」については、ASE/SPILやAmkorといったOSATの非TSMC系CoWoSプロセスを主に活用し、そのキャパシティが5万枚から27万枚へと急増している(なお旧XilinxのFPGA部門のCoWoS需要は1万枚で横ばいとなっている)2。
- Broadcomの拡大(2026年30万枚 → 2027年48.4万枚、前年比+61%): BroadcomはGoogleのTPU v7(Ironwood)およびv8i(開発コードネーム:SunFish)の設計・製造支援でCoWoSを消費するのに加え、AIクラスタにおける800Gおよび1.6Tスイッチの需要急増に対応するため、主力ネットワークスイッチ「Tomahawk」シリーズにおいて全面的にCoWoS先端パッケージを採用している2。別推計では2026年のBroadcomのCoWoS事前割当枠(約20万枚、前年比122%増)の約60〜65%がGoogle向け(TPUの外部供給計画を含む)とされている41。
- MediaTekの台頭(2026年4万枚 → 2027年18万枚、前年比+350%)とMarvellの急伸(2026年1.7万枚 → 2027年6.4万枚、前年比+276%): モバイルSoC大手のMediaTekはクラウド・エッジAI ASIC市場へ拡大しており、トップティア顧客の中で最速となる前年比350%増のCoWoS需要拡大が見込まれている2。サプライヤー情報によれば、MediaTekのASIC事業はGoogleの「TPU v8t(開発コードネーム:ZebraFish)」によって牽引されており、予想出荷数は360万ユニットに相当する2。一方、MarvellもカスタムAI ASICおよびDPU・高速AIネットワークチップ向けにCoWoS需要を2026年の1.7万枚から2027年には6.4万枚(前年比276%増)へと拡大させている2。
2.3 Broadcom(AVGO)およびMarvell(MRVL)の売上成長率とバリュエーションの再評価
カスタムASIC共同設計市場の約95%を握るBroadcom(デザインサービス市場シェア約60〜70%)とMarvell(同約20〜25%)の2社は、機関投資家のポートフォリオにおいて「大規模かつ多角化されたコンパウンダー(Compounder)」と「高レバレッジの純粋成長株(Breakout Pure-Play)」という対照的な特性を提供している1。
Broadcom(AVGO):高キャッシュフロー変換効率を誇るコンパウンダー
Broadcomの2026年度(FY2026)の業績は、カスタムAIアクセラレータとAIネットワーキングの双方で急拡大している。同社のAI半導体売上高は、2025年度(2025年11月期)の通期200億ドル(前年比65%増、全社売上639億ドルの31%)から、2026年度第1四半期に84億ドル(ガイダンス82億ドルを上回る着地)、第2四半期に108億ドル(前年同期比143%増、全社売上約222億ドル)、そして2026年9月発表の第3四半期決算では167億ドル(前年同期比221%増、前期比54%増)へと加速した1。第3四半期の全社売上高は295億9,000万ドル(前年同期比86%増、うち半導体ソリューション部門が208億4,000万ドルで全体の70%)に達し、AI半導体売上が初めて全社売上の過半を占めた11。さらに会社側は、第4四半期のAI半導体売上ガイダンスを217億ドル(全社Non-GAAP営業利益率は予想売上高の約66%)と提示しており、2026年度通期のAIチップ売上高は前年比186%増の580億ドル(予想全社売上の55%)に達する見通しと報じられている11。
バイサイド・アナリストが注目すべきは、Broadcomのキャッシュフロー創出力である。第3四半期において、Broadcomは295億9,000万ドルの売上高から136億7,000万ドルのフリーキャッシュフロー(FCF:前年同期比95%増)を創出した一方で、同四半期の設備投資額(CapEx)は5億3,000万ドルにとどまった11。ハイパースケーラーやファウンドリが年間数百億〜数千億ドルの巨額CapExを投じる中、ファブレス設計とIP・ソフトウェア(VMware)を軸とするBroadcomは極めて高い資本効率を維持している8。
ホック・タン(Hock Tan)CEOは730億ドルのAIバックログ(うち102.4TbpsのTomahawk 6等を中心とするAIスイッチのバックログが100億ドル超)を抱え、2027年の年間AIチップ売上目標として1,000億ドル超(アナリスト予想では2027年度に約1,150億ドルへ倍増、2028年度に2,300億ドルへ再倍増)を掲げている1。この目標が達成された場合、2025年度から2028年度にかけて売上高は年平均62%、EPSは年平均78%で成長すると試算されており、予想PER約18〜23.8倍(時価総額約1.4兆ドル、粗利益率約66.5%)というバリュエーションは成長率対比で割安感がある49。留意すべきリスク要因は、フルラックスケールAIソリューションの納入比率上昇に伴う粗利益率への下押し圧力と、AIバックログが主要5顧客(Google、Meta、OpenAI、Anthropic、Apple等)に集中している点であるが、Googleとは2031年までの長期供給契約を結んでいるほか、VMware事業が安定したキャッシュフロー基盤として機能している43。
Marvell Technology(MRVL):12〜24ヶ月の収益認識ラグを伴うカスタムASICパイプライン
一方、カスタムASIC市場の構造的ナンバー2(シェア20〜25%)であるMarvell Technologyは、2026年に株価が約3倍の約294ドルへと上昇している43。同社の2027年度第1四半期(2026年5月2日終了)売上高は前年同期比28%増の24億1,780万ドル(GAAP粗利益率52.1%・Non-GAAP粗利益率58.9%、営業キャッシュフローは過去最高の6億3,880万ドル)、続く第2四半期(2026年8月27日発表)売上高は前年同期比37%増の27億3,900万ドル(GAAP粗利益率53.1%・Non-GAAP粗利益率58.9%、うちデータセンター部門売上高は前年同期比46%増の21億7,000万ドル)と過去最高を更新し、第3四半期売上高も31億5,000万ドル(±5%)へと拡大が見込まれている11。
Marvellを評価する上では、同社のデータセンター事業における「2つの異なる収益認識サイクル」を理解する必要がある56。 第一のドライバーである「光DSP(Optical DSP:光トランシーバ内で電気信号と光信号を変換するPAM4 DSP)および高速Ethernetスイッチ(Teralynx等)」は、標準製品として受注から数週間程度で売上計上される短期ドライバーである56。AIクラスタの巨大化に伴い光トランシーバの必要数はGPU数以上のペースで増加しており、Marvellはさらに2026年2月2日に「Celestial AI」を、同年2月10日に「XConn Technologies」を相次いで買収完了し、光インターコネクトとスイッチング領域を強化している55。
第二のドライバーである「カスタムASIC(AWSのTrainium / InferentiaやMicrosoftのMaia等)」には、デザインウィン獲得から設計・テープアウト・検証を経て量産売上が計上されるまでに「12〜24ヶ月」のタイムラグが存在する42。したがって、2027年度第1四半期に計上されたカスタムASIC等の売上は2025年度第1四半期〜2026年度第1四半期に契約された案件によるものであり、マット・マーフィー(Matt Murphy)CEOが2027年度第1〜第2四半期決算で言及した新規デザインウィンや好調なAIブッキングが本格的に収益貢献するのは2028年度(FY2028)第1〜第3四半期以降となる54。業界推計では、Marvellのデータセンター売上高は2027年度の約80億ドル規模から2029年度には約200億ドル近くへ拡大するパスが示されており、集中リスクは伴うもののカスタムシリコンの加速に対する高いレバレッジを有している12。
第3章:非NVIDIA陣営の急拡大②――AMDの「ラックスケールサーバー戦略」と防衛・ソブリンAI需要
3.1 チップ単体売りから「ラックスケール統合」への昇華:ZT Systems買収とMI350 / MI400シリーズの競争力
カスタムASICと並ぶ非NVIDIA陣営のもう一方の柱が、リサ・スーCEO率いるAMDである。AMDは従来、MI300Xやその拡張版であるMI325X(256GB HBM3E、帯域約6TB/s)のように単体GPUのメモリ容量等で強みを発揮してきたが、2025年から2026年にかけて「単体GPUの販売」から「オープンなAIファクトリー全体のラックスケール統合」へと戦略を大きく転換した18。
その中核となったのが、システムエンジニアリングとラックスケールAI展開能力を強化するための「ZT Systems」の買収完了である18。これによりAMDは、サーバーCPU(EPYC Venice / Verano)、GPU(Instinct)、フロントエンドDPU(Pensando Salina)、バックエンドAI NIC(Pensando Pollara 400 / Vulcano 800)、スケールアップ/スケールアウト通信、液冷システム、そしてソフトウェア(ROCm)を一体化したラックスケール・リファレンスデザイン「Helios(ヘリオス)」を構築し、OEM/ODMが迅速に量産実装できる体制を整えた17。
製品ロードマップも急速に進化している。2025年6月に発表されたTSMC 3nm/6nmチップレット採用のCDNA4世代「Instinct MI350シリーズ」では、低精度フォーマット(MXFP4、MXFP6、MXFP8)を強化しつつHPC向けのFP64も維持し、「MI350X(256 Compute Units、消費電力1,000W、288GB HBM3E、帯域8TB/s、FP8 4.6 PFLOPS / MXFP4 9.2 PFLOPS)」および液冷データセンター向け高出力版「MI355X(消費電力1,400W、288GB HBM3E、帯域8TB/s、FP8 5 PFLOPS / MXFP4 10.1 PFLOPS)」を投入した18。続いて2026年7月23日の「Advancing AI 2026」イベントにおいて、次世代CDNA5アーキテクチャを採用した「Instinct MI400シリーズ(AI特化型のMI455XおよびHPC・ソブリンAI特化型のMI430X)」と、MI455Xを72基統合したラックシステム「Helios」を発表した18。
「Instinct MI455X」は、3,200億個のトランジスタを12個のチップレットで構成し、3Dハイブリッドボンディング(3D Hybrid Bonding)技術で統合している18。Samsung電子とのHBM4供給協力(2026年3月発表)等を通じて、1チップあたり432GBのHBM4メモリを搭載し、メモリ帯域幅は2026年初頭のCES時点での公表値(19.6TB/s)から引き上げられた23.3TB/s(MI355Xの8TB/sから大幅増)を実現している18。ピーク演算性能はMXFP4で約40 PFLOPS、FP8で約20 PFLOPSに達する18。また、2027年初頭投入予定の「MI430X」は、HPCやソブリンAI向けに倍精度(FP64)で288 TFLOPSの性能を備えている18。
3.2 NVIDIA NVL72に対するAMD「Helios」ラックの比較検証とUEC / UALink包囲網
現在のAIインフラ競争は、単体GPUではなく「72基のGPUを束ねたラックスケール・システム」が基本単位となっている17。AMDの「Helios(MI455X×72基搭載ラック)」と、NVIDIAの「GB200 / Vera Rubin NVL72」、および主要カスタムASICシステムの仕様を比較したのが以下のビジュアルである。
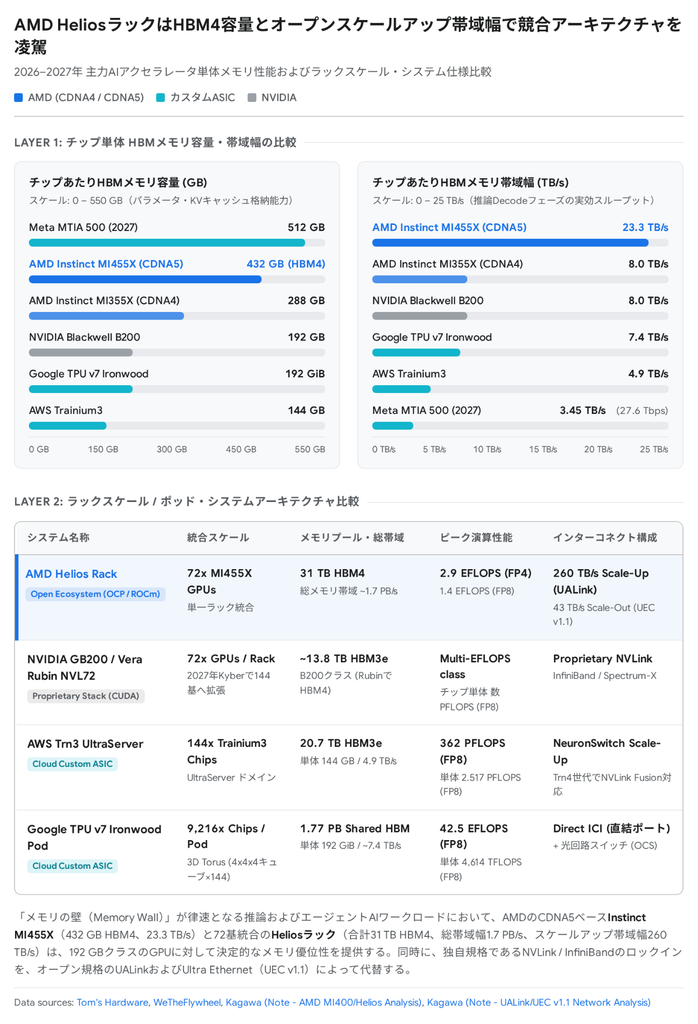
OCPの「Open Rack Wide」規格を採用するAMDの「Helios」ラックは、1ラックに72基のMI455X GPUを統合し、ラック全体で31TBのHBM4メモリと約1.7PB/sの総メモリ帯域幅、そしてFP4で最大2.9 EFLOPS、FP8で1.4 EFLOPSの演算性能を提供する18。AMDはこのHeliosラックがラックレベルのメモリ容量、総メモリ帯域幅、スケールアップ帯域(260TB/s)、およびトークンコスト効率においてNVIDIAのVera Rubin NVL72に対する競争優位性を持つと位置付けている(なおNVIDIA側も2027年には144基のGPUを束ねる「Kyber」ラックへの拡張を計画している)18。Heliosは2026年7月23日時点で量産に入っており、Microsoft Azure(ND MI455X v7)、OpenAI(2026年第4四半期より導入開始)、Meta、およびAnthropicに採用されている18。
さらに、AIネットワーク領域においても、NVIDIAの独自規格(NVLink+InfiniBand)に対し、オープン規格連合(Ultra Ethernet Consortium[UEC]およびUALink)が急速にシェアを拡大している17。
- スケールアウト領域におけるEthernetの台頭とUEC v1.1: 調査会社Dell’Oroによれば、2026年第1四半期(1〜3月期)にはAIバックエンド用スイッチ売上高の約3分の2をEthernetが占めた17。NVIDIA自身もSpectrum-X Ethernetを主力の一つに育てる一方、オープン陣営ではUECが2025年6月のSpecification v1.0に続き、2026年10月12日に「UEC Specification v1.1」を公開した17。 UEC対応チップ(Broadcomの51.2Tbpsスイッチ「Tomahawk Ultra」や102.4Tbpsの「Tomahawk 6」、Ciscoの「Silicon One G200」、AMDの400Gbps AI NIC「Pensando Pollara 400」および最大800Gbps接続・GPUあたり最大2.4Tbpsのスケールアウト帯域をサポートする「Pensando Vulcano 800」)は、以下の技術的特徴を備えている15。
- スモールパケット最適化と低遅延: Tomahawk Ultraは最小64バイトの極小パケットでも毎秒770億パケット(77B PPS)のフルレート処理を維持し、ポート間遅延を250ナノ秒(ns)以下、XPU間のエンドツーエンド遅延を400ns以下に抑える57。
- リンク層再送(LLR)とパケットスプレー: 通信エラー時にチップ内のハードウェアがミリ秒以下でパケットを再送するLink Layer Retry(LLR)や、パケットを複数経路に分散(インテリジェント・パケットスプレー)して受信側NICで順序整列(In-Order Delivery)を行う機能を搭載している16。AMDの製品資料によれば、Pollara 400はマルチプレーン展開により最大50%のネットワークコスト削減、InfiniBand比で最大20倍のGPUクラスタ規模(UEC全体では1論理ネットワークで最大100万ホスト)へのスケールアウト、RoCEv2比で収束時間を最大50%改善するRAS性能を掲げている16。またOpenAIが公開した通信プロトコル「MRC(Multipath Reliable Connection)」もUEC 1.0ベースのネットワーク信号輻輳制御(NSCC)を採用しており、AMDのVulcanoはこれをサポートしている17。
- ヘッダー圧縮とIn-Network Collectives(網内集団演算): 従来の46バイトのEthernetヘッダーを約10バイトに圧縮して転送効率を高めるほか、UEC v1.1ではスイッチ網内で集団演算を行う「In-Network Collectives」を追加し、大規模な集団通信に必要な帯域を半減させている17。
- スケールアップ領域への拡張(UALink Common 2.0とUEC v1.1 Unified Local): ラック内でアクセラレータ同士がLoad/Store型通信を行うスケールアップ領域では、NVLinkに対抗するオープン規格「UALink(Universal Accelerator Link)」が「UALink Common 2.0(In-Network Compute対応)」へと進化し、UEC v1.1もスケールアップ向けの「Unified Local」プロファイルを追加した17。AMDのHeliosラックは260TB/sのスケールアップ帯域と43TB/sのスケールアウト帯域を備えている17。もっとも、UALinkのスケールアップ製品は2026年末から出荷が始まる段階であり、すでに豊富な商用稼働実績を持つNVLinkに対して、マルチベンダー環境での大規模量産運用をどこまで安定実装できるかが2027年以降の重要な焦点となる17。
3.3 米国防総省(ペンタゴン)および機密(Air-Gapped)領域におけるAMDの好機
AMDのラックスケール戦略が商業クラウドと並んで存在感を高めているのが、米国防総省(ペンタゴン/War Department)および情報機関(Intelligence Community)、連邦政府機関の「機密・完全閉域網(Air-Gapped)ソブリンAIインフラ」市場である5。
2026年の防衛・インテリジェンス分野では、ISRセンサー、通信傍受(SIGINT)、地理空間画像(GEOINT)、オープンソース情報(OSINT)、人的情報(HUMINT)を単一の知識グラフに統合する「Multi-INT Fusion」や、ディープフェイク(合成メディア)対策など、AIは不可欠な運用基盤となっている5。しかし、機密環境においてはクラウドホスト型SaaSや推論根拠が不透明なブラックボックスAIは採用が難しく、オンプレミスかつエアギャップ(Air-Gapped:外部ネットワークから遮断された環境)でローカルLLMを実行する「ソブリンAI展開」が標準要件となりつつある5。具体的には、インパクトレベル4および5(IL4 / IL5)やSCIF(機密情報隔離施設)等において以下の4要件が求められている6。
- データ居住性(Data Residency)とエアギャップ能力: すべてのクエリ、応答、知識ベースが機関のネットワーク境界内に留まり、商用プロバイダーの推論サーバーへ一切ルーティングされず、オフラインで稼働すること6。
- NIST 800-53およびSTIG / RMF準拠: 連邦情報システムのセキュリティ管理策(NIST 800-53)、役割ベースのアクセス制御、監査証跡(FOIA情報公開請求や監察官調査に対応可能なログ記録)、説明可能なAI(Explainable AI:交戦規定[ROE]遵守のためのトレーサビリティ)の実装5。
- モデルの来歴管理(Provenance)と更新ガバナンス: 外部ベンダーによる不透明なモデル更新を防ぎ、機関側がモデルバージョンを固定(Pinning)・検証・所有できること6。
- TCOの大幅削減: 10,000人の職員を抱える省庁が商用クラウドAIのシート課金(月額30ドル/人以上)を支払うと年間360万ドル以上の支出が継続するのに対し、自前のソブリンAIインフラを構築すれば数分の一のコストで資産を所有できる38。
国防総省はSpaceX、OpenAI、Google、NVIDIAを含むフロンティアAI企業8社と機密ネットワーク向けAI協定を結んでおり、サウジアラビアのHUMAIN等の大規模ソブリンAIプログラムでもNVIDIA製GPUと並んでAMDがパートナーとして選定されている31。こうした中、NVIDIAのCEOを巡る国家安全保障・ガバナンス上の調査が発生したことは、サプライチェーンの完全性とシングルベンダー・ロックインの排除を重視する防衛・政府調達機関にとって、ガバナンス上の懸念がなくインライン暗号化機能付きNIC(Pensando Pollara等)からCPU・GPUまでをオープン規格で提供できるAMDのラックスケール基盤をセカンドソースおよび主軸の一つとして採用する追い風となっている3。
第4章:最大のゲームチェンジャー――SpaceX・Tesla・xAI「Terafab(テラファブ)」の衝撃
5000円以上のレポートは、当サイトが発行する請求書/インボイスによる銀行振込のお支払いに対応します。お問合せはinfo@sattu-ai-agent.com まで。請求書発行に先立つ見積書発行も可能です。
決済ツール Codoc によるクレジットカードのお支払いは、初回に Codoc への会員登録(IDとパスワード)が必要になります。インボイス対応の領収書が出ます。お問合せは info@sattu-ai-agent.com まで。